RadioGeek
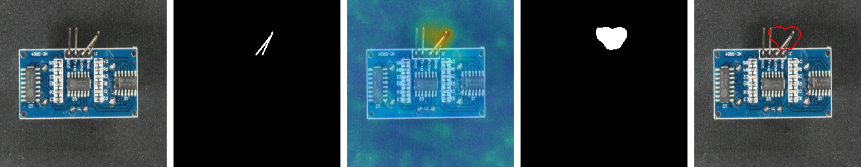
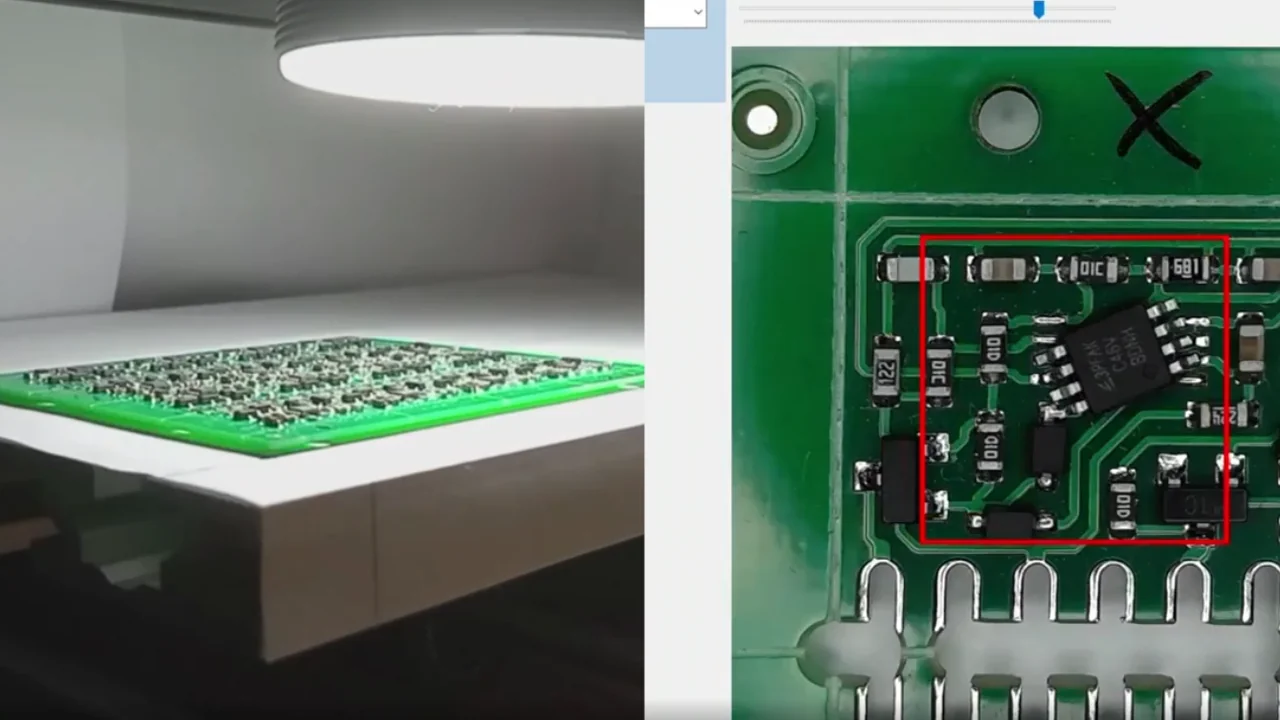
Визуальный контроль на практике часто упирается не в модель, а в данные: хороших снимков изделия много, а дефектов мало, и их список непредсказуем — царапина, недопай, загрязнение, отсутствующий элемент, смещение. Учить классификатор по всем вариантам бессмысленно: завтра появится дефект, которого не было в разметке. Класс методов решает задачу иначе: модель обучается на «нормальных» изображениях и на приёмке оценивает, насколько снимок от них отклоняется.
Anomalib — открытая библиотека, которая собирает такие алгоритмы в одном месте. Полезный вопрос здесь не «есть ли готовая модель на все случаи», а «как быстро проверить, что схема вообще работает на моих фотографиях, и что понадобится для промышленной эксплуатации». Ниже — что подтверждается официальной документацией и release notes, а что остаётся непроверенным нами.
Что это за библиотека
- Официальная формулировка: «библиотека для бенчмаркинга, разработки и развёртывания алгоритмов глубокого обучения обнаружения аномалий» с фокусом на визуальное обнаружение — найти и/или локализовать аномалию на изображении или в видеопотоке.
- Лицензия и установка: Apache-2.0, ставится из PyPI (
pip install anomalibилиuv pip install anomalib), Python 3.10+, PyTorch 2.10+ (минимум поднят в версии 2.7.0), реализации моделей — на PyTorch Lightning. - Происхождение: проект начинался в Intel, первая публикация — IEEE ICIP 2022; сейчас развивается в организации open-edge-platform на GitHub. На дату проверки — более 6 300 звёзд и регулярные релизы: v2.0.0 — 19.03.2025, v2.3.0 — 20.03.2026, актуальная v2.7.0 — 06.10.2026; промежуточные минорные версии выходят примерно раз в 6–8 недель.
- Позиционирование авторов: крупнейшая публичная подборка готовых алгоритмов обнаружения аномалий и бенчмарк-датасетов; плюс инструменты, чтобы не переписывать статьи, а сравнивать подходы на своих данных.
Как устроена работа с библиотекой
| Что даёт | Практический смысл | |
|---|---|---|
| Коллекция моделей | Padim, Patchcore, EfficientAd, STFPM, CFlow, CFA, Dinomaly, SuperSimpleNet, AnomalyDINO, в 2026-м — MH-PatchCore, RAD и few-shot FoundAD | выбирать алгоритм под объём данных, а не начинать с нуля |
| Датасеты | встроенные загрузчики бенчмарков, включая MVTec AD и Kaput (добавлен в v2.3.0) | общая точка сравнения: качество видно до закупки железа |
| Свои данные | структура папок и конфигурационный YAML | перенос с бенчмарка на свои фотографии без переписывания кода |
| CLI и Engine | anomalib train --config ..., anomalib predict ..., бенчмаркинг нескольких моделей, Python API | обучение и прогон оформляются как обычный инженерный скрипт |
| Метрики и порог | метрики уровня изображения и карты дефекта, постобработка MEBin (с v2.3.0), пороги F1Adaptive/F1Max | без размеченной валидации порог не выбрать — это часть дизайна библиотеки |
| Эксперименты | интеграция с Weights & Biases, Comet, TensorBoard; оптимизация гиперпараметров | история прогонов — обычная инженерная практика |
| Экспорт | ONNX через dynamo-экспортёр, OpenVINO IR (экстра anomalib[openvino]) | вывод инференса за пределы обучающего стека |
| Бэкенды | extras cpu, cu126, cu130, rocm, xpu; обучение на Intel GPU (Arc 750/770) — пока только на одном GPU | запуск от laptop-CPU до рабочей станции без смены API |
Отдельная история — Anomalib Studio: low/no-code веб-приложение, которое берёт поток с USB или IP-камеры либо папку изображений, обучает модель и отдаёт результат в промышленные конвейеры через ROS- и MQTT-сообщения; поставляется как Docker-контейнер или отдельное приложение. Официально помечено как pre-release: функциональность может быть неполной и нестабильной — строить на нём производство сейчас преждевременно, следить за развитием — полезно.
Что принесли релизы 2026 года
- v2.3.0 (20.03.2026): модель AnomalyDINO (подход на опорных vision-моделях), обновлённая SuperSimpleNet, обучение Patchcore в половинной точности, «голый» режим движка (barebones) для интеграций без лишней обвязки, датасет Kaput, постобработка MEBin; устранён узкий расход видеопамяти при kNN-инференсе Patchcore, исправлен экспорт INT8.
- v2.7.0 (06.10.2026): три новые модели — MH-PatchCore, RAD (retrieval-based) и few-shot FoundAD; по безопасности checkpoint загружаются с
weights_only=Trueпо умолчанию, а пути в метаданных датасета обязаны резолвиться внутри указанногоroot; удалён legacy ONNX-экспортёр (остаётся dynamo, для OpenVINO обязателен экстра пакета), минимальный PyTorch поднят до 2.10 (для ROCm — 2.13); исправлена метрика AUPR — теперь step-wise average precision.
Смысл этих строк для планировщика работ: релизный цикл живой, и апгрейд версии библиотеки — отдельная инженерная задача (зависимости и формат экспорта меняются заметно), а не «pip install -U» в рабочем контуре.
Применение к нашему направлению
Типовой сценарий визуального контроля плат и узлов ложится на библиотеку почти напрямую:
- «Золотой образец» вместо каталога дефектов. Фотографируем годные изделия, обучаем базовую модель (Patchcore — классика memory-bank-подхода), получаем карту отклонений по пикселям и оценку по всему кадру.
- Проверка осуществимости до инвестиций. На CPU-экстра и паре сотен кадров можно за один рабочий день увидеть, «шумит» схема на вашем освещении или реально ловит дефекты — до закупки промышленной камеры и света.
- Мало дефектов — few-shot. AnomalyDINO, FoundAD и RAD в подборке как раз про ситуацию, когда размеченных примеров дефекта единицы.
- Edge-инференс. Экспорт в OpenVINO IR заявлен для ускоренного запуска на Intel-железе: пограничный ПК у конвейера без GPU-сервера — типовой кандидат. Сами мы скорость на конкретном железе не мерили.
Границы и риски
- Бенчмарки — не ваша линия. AUROC на MVTec AD не переносится на вашу сцену: другое освещение, другой ракурс, другие изделия. Метрики и порог надо считать заново на собственных данных — иначе «промышленная точность» из чужих таблиц превращается в красивые отчёты без покрытия.
- Порог требует валидации с дефектами. Качество детекции — компромисс ложных срабатываний и пропусков; без размеченного набора с аномалиями выбрать его невозможно. Библиотека честно отражает это в своих метриках, но данные должны быть ваши.
- Лицензии датасетов — отдельная проверка. Сама библиотека под Apache-2.0, но у бенчмарк-датасетов собственные условия: MVTec AD, например, предоставляется под исследовательское использование, а коммерческое оформляется отдельно. Прежде чем строить продукт на данных бенчмарка, проверяйте лицензию.
- Проект активно меняется. Путь v2.0.0 → v2.7.0 за полтора года включает удаления публичных API и рост минимальных зависимостей; интеграции придётся планировать с учётом обновлений.
- Studio — pre-release. Официальное предупреждение о неполноте и неустойчивости; о промышленной эксплуатации в нём речи нет.
Как проверить под свою задачу
- Собрать данные: несколько сотен кадров годного изделия и небольшой размеченный валидационный набор с реальными дефектами.
- Поставить
anomalib[cpu]и прогнать пример на MVTec AD — посмотреть, как выглядят score, тепловая карта и пороговая метрика. - Описать структуру своих данных по документации и обучить базовую модель (Patchcore как консервативный выбор, AnomalyDINO или FoundAD — когда дефектов мало).
- Сравнить две-три модели по AUROC/F1 на своей валидации и выбрать порог исходя из цены пропуска и цены ложного срабатывания в вашей технологии.
- Экспортировать выбранную модель в ONNX/OpenVINO и померить скорость и память на целевом железе.
- И только после этого решать форму эксплуатации: сервис вокруг библиотечного инференса, демонстрация через Gradio или Studio (с оглядкой на pre-release статус).
Полезные ссылки
- Репозиторий проекта на GitHub.
- Документация на официальном сайте.